Resuma este artigo com IA


Quer ver mais deste site no Google?
Adicione este site às suas fontes preferidas.

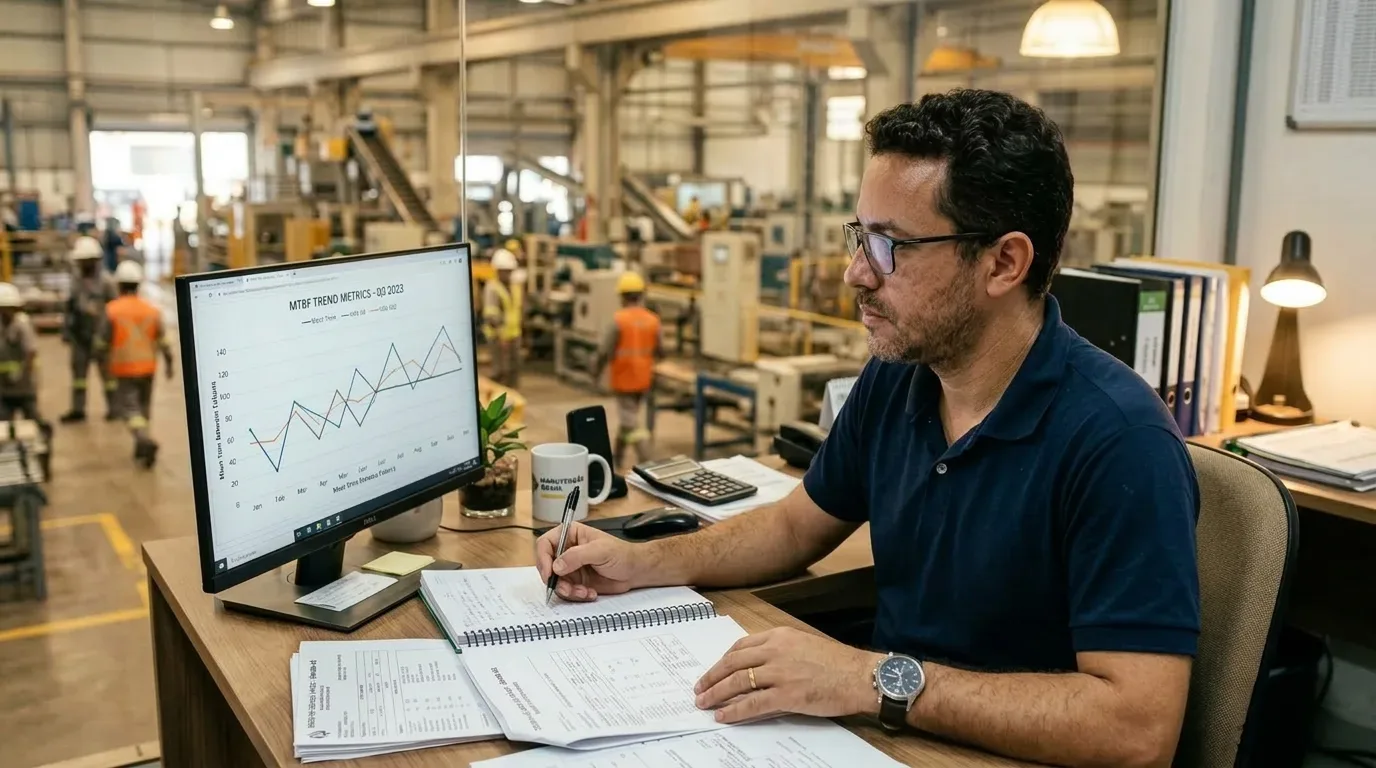
Na prática, aplicar MTBF na manutenção significa calcular o tempo médio entre falhas e usar a tendência, não uma média isolada, para rever inspeções e prioridades. MTBF é a sigla de Mean Time Between Failures (tempo médio entre falhas). O indicador só orienta decisões quando o histórico registra horas operadas e ocorrências de modo consistente, como explica o material sobre cálculo e uso do MTBF na manutenção preventiva.
Com essa leitura, a equipe deixa de tratar cada parada como surpresa e passa a investigar padrões antes que eles pressionem produção e caixa. O ganho está em escolher a ação adequada, não em transformar uma média histórica em promessa sobre a próxima falha.
O que o MTBF mede
O MTBF mede o tempo médio de operação entre falhas de um equipamento reparável. Seu cálculo divide o total de horas em operação pelo número de falhas registradas no período analisado.
MTBF = horas de operação ÷ número de falhas. Se um ativo operou 360 horas e apresentou três falhas, o resultado é 120 horas operadas por falha, em média. Esse exemplo ilustra a conta, mas não prevê que a próxima ocorrência acontecerá exatamente após 120 horas.
Para a conta servir à gestão, defina antes quais eventos entram como falha e qual período será observado. O registro também precisa separar tempo produtivo de paradas planejadas, pois misturar bases diferentes distorce a comparação.
- Considere as horas efetivamente operadas pelo ativo;
- Conte falhas conforme um critério documentado e estável;
- Compare períodos com a mesma regra de registro;
- Analise equipamentos equivalentes ou explique as diferenças de processo.
O valor ganha sentido quando aparece junto da disponibilidade, do tempo de reparo e da criticidade operacional. Para ampliar essa visão, o artigo sobre indicadores de manutenção e sua relação com a confiabilidade ajuda a conectar métricas sem reduzir a análise a um único número.
A tendência revela mudanças
Um MTBF que cai em períodos comparáveis sinaliza que as falhas estão ocorrendo com maior frequência dentro da rotina observada. O número não identifica a causa sozinho, mas indica onde a equipe deve conferir condições de operação, intervenções e componentes envolvidos.
Considere um exemplo hipotético: em uma janela, a máquina acumula 420 horas de operação e três falhas, resultando em 140 horas por falha. Em outra janela equivalente, quatro ocorrências reduzem a média para 105 horas.
A diferença merece investigação, não uma troca automática de peças. Verifique se mudou a carga da máquina, a matéria-prima, o procedimento de reparo ou a forma de registrar ocorrências. Qualquer alteração pode explicar parte da variação.
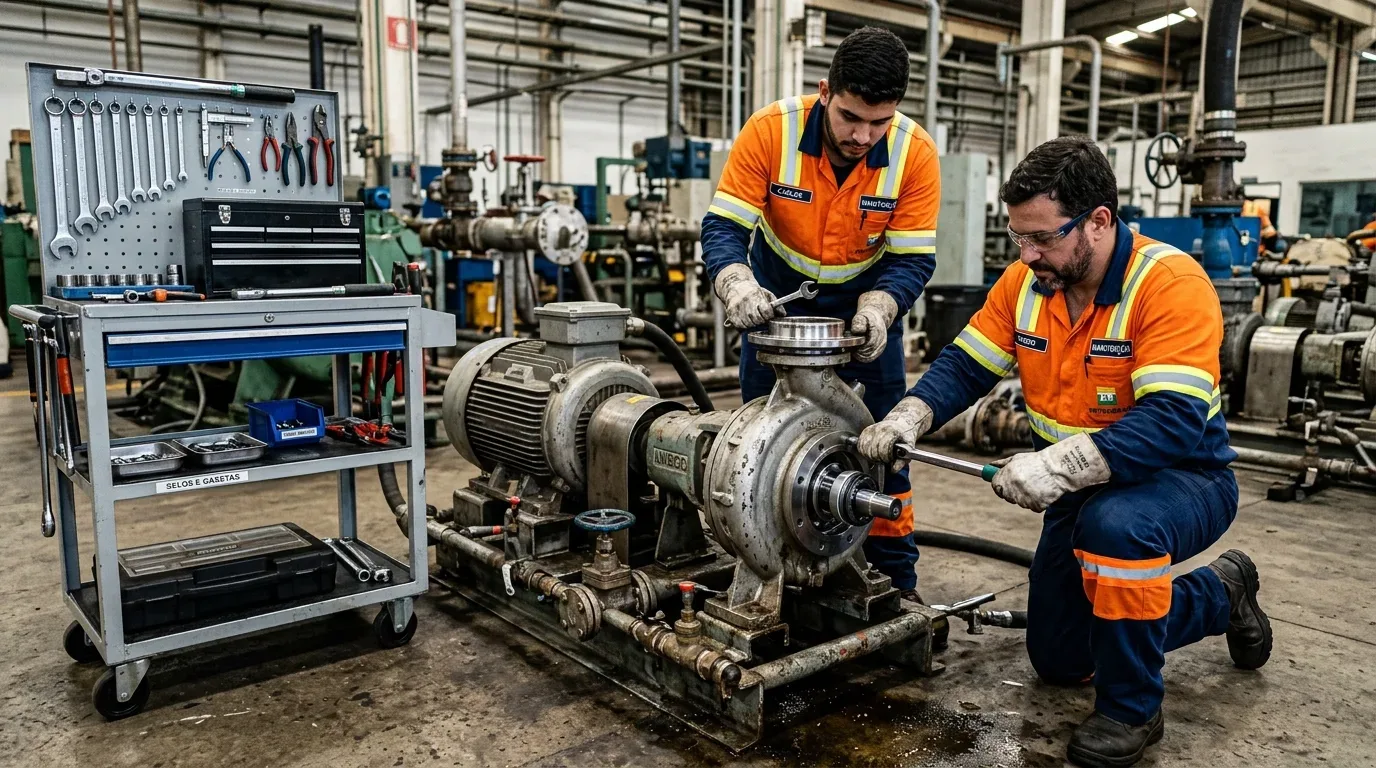
Quando as falhas se repetem, a equipe deve registrar modo, componente e condição encontrados em cada intervenção. Uma análise estruturada das falhas recorrentes ajuda a separar coincidência de causa repetida, evitando que o indicador vire apenas mais uma coluna no relatório.
Como transformar o histórico em ação
O uso prático do indicador começa no cadastro confiável e termina em uma decisão verificável. Um fluxo simples mantém a análise próxima da rotina do planejador, sem exigir que a fábrica interrompa a produção para reorganizar todos os dados.
- Escolha o ativo: comece por equipamentos cuja parada afeta segurança, capacidade ou atendimento;
- Padronize o registro: anote início, fim, componente, sintoma, causa confirmada e serviço executado;
- Calcule por período: use horas operadas e falhas contabilizadas com o mesmo critério;
- Compare o comportamento: procure queda persistente, concentração de falhas ou melhora após uma intervenção;
- Defina uma resposta: ajuste inspeção, procedimento, estoque técnico ou intervalo de acompanhamento;
- Confira o efeito: acompanhe os períodos seguintes e registre se a ação alterou a recorrência.
Esse ciclo conecta o indicador ao planejamento, em vez de deixar a equipe reagir somente depois da parada. Um plano de manutenção de equipamentos organiza tarefas, responsáveis e frequências para que a decisão tenha continuidade.
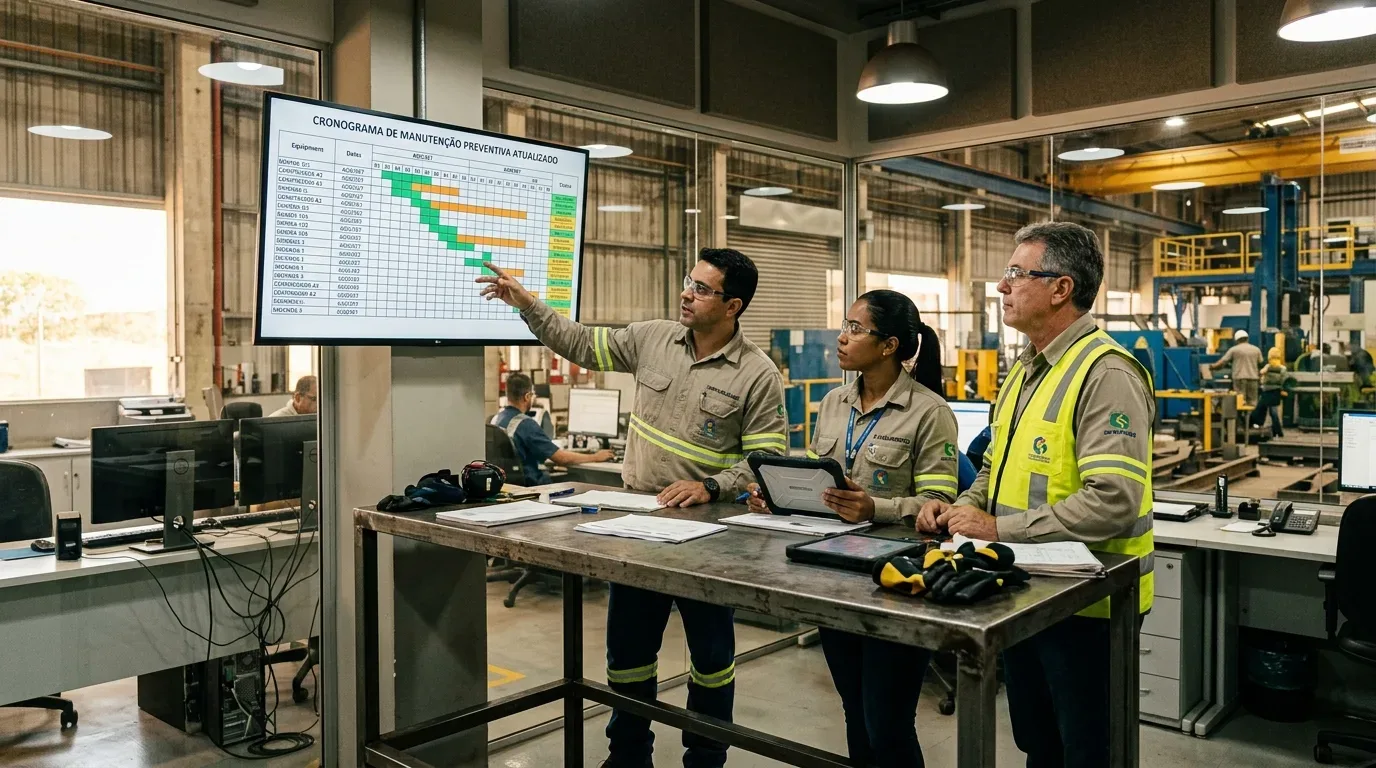
Na prática, uma piora persistente pode justificar inspeções mais frequentes ou uma revisão técnica, mas a escolha depende do modo de falha. Se o histórico aponta desgaste progressivo, técnicas de manutenção preditiva para acompanhar a condição do ativo podem complementar o calendário preventivo.
Quais métricas completam a análise
O MTBF descreve frequência média entre falhas, enquanto o MTTR, sigla de Mean Time To Repair (tempo médio para reparo), representa o tempo médio para reparar o equipamento. Juntos, ajudam a distinguir uma máquina que falha pouco, mas demora a voltar, de outra que falha mais e é recuperada rapidamente.
Essa distinção muda a prioridade. Um equipamento com intervalo crescente entre falhas ainda pode causar impacto relevante se cada reparo exigir uma parada longa, peças difíceis de obter ou assistência especializada.
Também avalie a disponibilidade, o volume produzido durante o período e o efeito das ocorrências no plano de produção. A leitura combinada impede que uma melhora estatística esconda uma perda operacional importante.
Se a equipe acompanha resultados em ciclos regulares, o ciclo de melhoria contínua aplicado à indústria oferece uma estrutura para testar ajustes, verificar efeitos e corrigir o plano com base em evidências.
Onde o indicador perde força
O MTBF perde confiabilidade quando a equipe registra algumas falhas e ignora outras, altera critérios no meio da série ou mistura equipamentos com condições de trabalho diferentes. Nesses casos, uma média precisa na aparência pode sustentar uma decisão ruim.
Outra limitação é tratar o resultado como prazo garantido. Falhas não ocorrem em intervalos perfeitamente regulares. Além disso, a média passada não informa sozinha o estado atual do componente nem as condições futuras de operação.
Por isso, use o indicador como sinal para investigar, priorizar e acompanhar. Para manter a análise consistente, registre cada ordem de serviço em um fluxo único; o conteúdo sobre critérios para organizar a manutenção em um sistema ajuda a avaliar essa necessidade.
Monitore o MTBF dos seus equipamentos e aumente a confiabilidade da sua indústria
Monitorar o MTBF dos seus ativos e prever falhas operacionais exige centralizar os registros de produção e manutenção em uma única plataforma. O SGPlan fornece a estrutura ideal para padronizar ordens de serviço, acompanhar indicadores de confiabilidade em tempo real e transformar dados do chão de fábrica em planejamento estratégico.
Fale com os especialistas do SGPlan e saiba como a nossa solução pode ajudar na gestão da sua fábrica.
Perguntas frequentes
O MTBF prevê a data da próxima falha?
Não. O MTBF resume o intervalo médio observado entre falhas; ele não informa uma data garantida para a próxima ocorrência. A condição atual do equipamento e o contexto operacional precisam ser avaliados separadamente.
Como calcular o MTBF de uma máquina?
Divida as horas efetivamente operadas pelo número de falhas registradas no período. Por exemplo, 360 horas de operação divididas por três falhas resultam em 120 horas médias entre falhas.
O que fazer quando não houve falha no período?
Não existe uma divisão válida por zero, portanto não atribua um valor finito de MTBF. Registre as horas sem ocorrência e mantenha a observação para comparar períodos futuros.
É correto comparar máquinas diferentes?
A comparação só ajuda quando os ativos têm função, regime e critérios de registro semelhantes. Se as condições diferem, analise cada histórico separadamente ou deixe explícitas as diferenças antes de decidir prioridades.
Como manter o histórico de manutenção organizado?
Registre falhas, horas de operação, componentes e serviços em ordens de trabalho com critérios padronizados. Um sistema de manutenção com histórico centralizado pode facilitar a consulta e a comparação dos dados.
Última atualização em 19 de October de 2026